高级数据操作
新增数据
多数据插入
只要写一次insert指令,但是可以直接插入多条记录
基本语法:INSERT INTO 表名[(字段列表)] VALUES(值列表1),(值列表2),...;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | mysql> DESC my_gbk;+-------+----------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+-------+----------------+------+-----+---------+-------+| name | varchar(20000) | YES | | NULL | |+-------+----------------+------+-----+---------+-------+1 row in set (0.00 sec)mysql> SELECT * FROM my_gbk;Empty set (0.00 sec)mysql> INSERT INTO my_gbk VALUES('Tom'),('Jack'),('John');Query OK, 3 rows affected (0.00 sec)Records: 3 Duplicates: 0 Warnings: 0mysql> SELECT * FROM my_gbk;+------+| name |+------+| Tom || Jack || John |+------+3 rows in set (0.00 sec) |
主键冲突
主键冲突:在有的表中,使用的是业务主键(字段有业务含义),但是往往在进行数据插入的时候,又不确定数据表中是否已经存在对应的主键
如果待插入的记录的主键在数据库已经存在,此时数据库系统就会报错
1 2 3 4 5 6 7 8 9 10 11 12 13 | mysql> SELECT * FROM my_student;+---------+----------+| stu_id | stu_name |+---------+----------+| stu0001 | 张三 || stu0002 | 张四 || stu0003 | 张五 || stu0004 | 张六 |+---------+----------+4 rows in set (0.00 sec)mysql> INSERT INTO my_student VALUES('stu0004','小婷');ERROR 1062 (23000): Duplicate entry 'stu0004' for key 'PRIMARY' |
那么这个问题该怎么解决呢?mysql中提供了两种解决方案
-
主键中突更新:
类似插入数据语法,如果插入的过程中主键冲突,那么采用更新方法
INSERT INTO 表名[(字段列表)] VALUES(值列表) ON DUPLICATE KEY UPDATE 字段=新值;
提示:duplicate是“重复”的意思
123456789101112131415161718192021222324252627282930313233mysql> DESC my_student;+----------+-------------+------+-----+---------+-------+| Field | Type | Null | Key | Default | Extra |+----------+-------------+------+-----+---------+-------+| stu_id | varchar(10) | NO | PRI | NULL | || stu_name | varchar(10) | NO | | NULL | |+----------+-------------+------+-----+---------+-------+2 rows in set (0.04 sec)mysql> SELECT * FROM my_student;+---------+----------+| stu_id | stu_name |+---------+----------+| stu0001 | 张三 || stu0002 | 张四 || stu0003 | 张五 || stu0004 | 张六 |+---------+----------+4 rows in set (0.00 sec)mysql> INSERT INTO my_student VALUES('stu0004','小婷') ON DUPLICATE KEY UPDATE stu_name='小婷';Query OK, 2 rows affected (0.00 sec)mysql> SELECT * FROM my_student;+---------+----------+| stu_id | stu_name |+---------+----------+| stu0001 | 张三 || stu0002 | 张四 || stu0003 | 张五 || stu0004 | 小婷 |+---------+----------+4 rows in set (0.00 sec)如果仔细观察我们会发现一个问题,为啥更新了一条影响行数为2呢?这个问题 官方文档给出了说明
With ON DUPLICATE KEY UPDATE, the affected-rows value per row is 1 if the row is inserted as a new row, 2 if an existing row is updated, and 0 if an existing row is set to its current values. If you specify the CLIENT_FOUND_ROWS flag to the mysql_real_connect() C API function when connecting to mysqld, the affected-rows value is 1 (not 0) if an existing row is set to its current values.
翻译如下
对于重复键更新,如果将行插入为新行,则每一行的受影响行值为1,如果更新现有行,则为2,如果将现有行设置为其当前值,则为0。如果在连接到mysqld时向mysql_real_connect() C API函数指定CLIENT_FOUND_ROWS标志,如果将现有行设置为其当前值,则受影响的行值为1(而不是0)。
其实只要这样想就好了,这是为了区分到底是插入了还是更新,返回1表示插入成功,2表示更新成功
-
主键冲突替换:
当主键冲突之后,干掉原来的数据,重新插入一条新的进去,它的语法和insert极其相似
REPLACE INTO 表名[(字段列表)] VALUES(值列表);
123456789101112131415161718192021222324mysql> SELECT * FROM my_student;+---------+----------+| stu_id | stu_name |+---------+----------+| stu0001 | 张三 || stu0002 | 张四 || stu0003 | 张五 || stu0004 | 小婷 |+---------+----------+4 rows in set (0.00 sec)mysql> REPLACE INTO my_student VALUES('stu0001','夏洛');Query OK, 2 rows affected (0.00 sec)mysql> SELECT * FROM my_student;+---------+----------+| stu_id | stu_name |+---------+----------+| stu0001 | 夏洛 || stu0002 | 张四 || stu0003 | 张五 || stu0004 | 小婷 |+---------+----------+4 rows in set (0.00 sec)
蠕虫复制
蠕虫复制:一分为二,成倍的增加。从已有的数据中获取数据,并且将获取到的数据插入到数据表中
基本语法:INSERT INTO 表名[(字段列表)] SELECT 字段列表 FROM 表名;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 | mysql> CREATE TABLE my_simple( -> name char(1) NOT NULL -> );Query OK, 0 rows affected (0.04 sec)mysql> INSERT INTO my_simple VALUES('a'),('b'),('c'),('d');Query OK, 4 rows affected (0.01 sec)Records: 4 Duplicates: 0 Warnings: 0mysql> SELECT * FROM my_simple;+------+| name |+------+| a || b || c || d |+------+4 rows in set (0.00 sec)mysql> -- 蠕虫复制mysql> INSERT INTO my_simple(name) SELECT name FROM my_simple;Query OK, 4 rows affected (0.01 sec)Records: 4 Duplicates: 0 Warnings: 0mysql> SELECT * FROM my_simple;+------+| name |+------+| a || b || c || d || a || b || c || d |+------+8 rows in set (0.00 sec)mysql> -- 蠕虫复制mysql> INSERT INTO my_simple(name) SELECT name FROM my_simple;Query OK, 8 rows affected (0.00 sec)Records: 8 Duplicates: 0 Warnings: 0mysql> SELECT * FROM my_simple;+------+| name |+------+| a || b || c || d || a || b || c || d || a || b || c || d || a || b || c || d |+------+16 rows in set (0.00 sec) |
注意:
- 蠕虫复制的确通常是重复数据,没有太大业务意义:可以在短期内快速增加表的数据量,从而可以测试表的压力,还可以通过大量数据来测试表的效率(索引)
- 蠕虫复制虽好,但是要注意主键冲突
提示:蠕虫复制可以配合创建表语句(使用like关键字可以拷贝表结构“CREATE TABLE 新表名 LIKE 待复制表名;”)来快速拷贝一张已经存在的表
更新数据
1、在更新数据的时候,特别要注意:通常一定是跟随条件更新
基本语法:UPDATE 表名 SET 字段名=新值 WHERE 判断条件;
2、如果没有条件,是全表更新数据。但是可以使用LIMIT来显示更新的数量,
基本语法:UPDATE 表名 SET 字段名=新值 [WHERE 判断条件] LIMIT 数量;
示例,将表中前4个a改成e
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 | mysql> SELECT * FROM my_simple;+------+| name |+------+| a || b || c || d || a || b || c || d || a || b || c || d || a || b || c || d || a || b || c || d || a || b || c || d || a || b || c || d || a || b || c || d |+------+32 rows in set (0.00 sec)mysql> UPDATE my_simple SET name='e' WHERE name='a' LIMIT 4;Query OK, 4 rows affected (0.00 sec)Rows matched: 4 Changed: 4 Warnings: 0mysql> SELECT * FROM my_simple;+------+| name |+------+| e || b || c || d || e || b || c || d || e || b || c || d || e || b || c || d || a || b || c || d || a || b || c || d || a || b || c || d || a || b || c || d |+------+32 rows in set (0.00 sec) |
删除数据
1、删除数据的时候尽量不要全部删除,应该使用where进行判定
2、删除数据的时候可以使用limit来限制要删除的具体数量
3、Delete删除数据的时候无法重置auto_increment
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | mysql> DELETE FROM my_auto;Query OK, 0 rows affected (0.00 sec)mysql> SHOW CREATE TABLE my_auto;+---------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+| Table | Create Table |+---------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+| my_auto | CREATE TABLE `my_auto` ( `id` int(11) NOT NULL AUTO_INCREMENT, `name` varchar(10) NOT NULL COMMENT '用户名', `pass` varchar(50) NOT NULL COMMENT '密码', PRIMARY KEY (`id`)) ENGINE=InnoDB AUTO_INCREMENT=6 DEFAULT CHARSET=utf8 |+---------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+1 row in set (0.00 sec)mysql> INSERT INTO my_auto VALUES(NULL,'ZhangSan',321456);Query OK, 1 row affected (0.01 sec)mysql> SELECT * FROM my_auto;+----+----------+--------+| id | name | pass |+----+----------+--------+| 6 | ZhangSan | 321456 |+----+----------+--------+1 row in set (0.00 sec) |
可以看到,即使已经将表中的数据全部删除,再插入一个数据id并不会恢复到“1”
这个问题该怎么解决呢?
Mysql有一个能够重置表选项中的自增长的语法:
TRUNCATE 表名;
提示:truncate是“截断”的意思
可以理解成直接将表先删除再创建一个一样结构的表
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | mysql> TRUNCATE my_auto;Query OK, 0 rows affected (0.08 sec)mysql> SHOW CREATE TABLE my_auto;+---------+-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+| Table | Create Table |+---------+-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+| my_auto | CREATE TABLE `my_auto` ( `id` int(11) NOT NULL AUTO_INCREMENT, `name` varchar(10) NOT NULL COMMENT '用户名', `pass` varchar(50) NOT NULL COMMENT '密码', PRIMARY KEY (`id`)) ENGINE=InnoDB DEFAULT CHARSET=utf8 |+---------+-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+1 row in set (0.00 sec)mysql> INSERT INTO my_auto VALUES(NULL,'ZhangSan',321456);Query OK, 1 row affected (0.00 sec)mysql> SELECT * FROM my_auto;+----+----------+--------+| id | name | pass |+----+----------+--------+| 1 | ZhangSan | 321456 |+----+----------+--------+1 row in set (0.00 sec) |
查询数据
完整语法:SELECT 选项 字段列表 FROM 数据源 WHERE 条件 GROUP BY 分组 HAVING 条件 ORDER BY 排序 LIMIT 限制;
Select的选项:系统该如何对待查询得到的结果
- All:默认就是这个选项,表示保存所有的记录
- Distinct(不同的):去重,去除重复(所有的字段都相同才算重复)的记录,只保留一条
示例
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 | mysql> SELECT * FROM my_simple;+------+| name |+------+| a || b || c || d || a || b || c || d |+------+8 rows in set (0.01 sec)mysql> SELECT ALL * FROM my_simple;+------+| name |+------+| a || b || c || d || a || b || c || d |+------+8 rows in set (0.00 sec)mysql> SELECT DISTINCT * FROM my_simple;+------+| name |+------+| a || b || c || d |+------+4 rows in set (0.00 sec) |
写字段列表的时候要注意,有的时候需要从多张表获取数据,在获取数据的时候,可能存在不同表中有同名的字段,需要将同名的字段命名成不同名的,此时需要使用别名alias
基本语法:字段名 [AS] 别名;
注意:同一个字段可以同时使用不同别名取出
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | mysql> SELECT * FROM my_simple;+------+| name |+------+| a || b || c || d || a || b || c || d |+------+8 rows in set (0.00 sec)mysql> SELECT DISTINCT name AS name1,name AS name2 FROM my_simple;+-------+-------+| name1 | name2 |+-------+-------+| a | a || b | b || c | c || d | d |+-------+-------+4 rows in set (0.01 sec) |
FROM+数据源
数据源为前面的查询提供数据,数据源只要是一个符合二维表结构的数据即可
单表数据
FROM后面只跟一张表
1 2 3 4 5 6 7 8 9 10 11 12 13 | mysql> SELECT * FROM my_simple;+------+| name |+------+| a || b || c || d || a || b || c || d |+------+ |
多表数据
FROM后面跟不只一张表
基本语法:FROM 表1,表2,...;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | mysql> SELECT * FROM my_simple;+------+| name |+------+| a || b || c || d |+------+4 rows in set (0.00 sec)mysql> SELECT * FROM my_int;+------+| num |+------+| 0001 || 0002 |+------+2 rows in set (0.00 sec)mysql> SELECT * FROM my_simple,my_int;+------+------+| name | num |+------+------+| a | 0001 || a | 0002 || b | 0001 || b | 0002 || c | 0001 || c | 0002 || d | 0001 || d | 0002 |+------+------+8 rows in set (0.00 sec) |
观察结果可知,查询一张有4条记录的表和一张有2条记录的表,最终结果有4×2=8条记录,这个过程就类似于求两个集合的笛卡尔积,这个结果除了给数据库造成压力,没有其他意义,应该尽量避免出现笛卡尔积
动态数据
FROM后面跟的数据不是一个实体表,而是一个从表中查询出来得到的二维结果表(子查询)
基本语法:FROM (SELECT 字段列表 FROM 表名) AS 别名;
注意这其中的括号和别名都是不能省略的
错误示例
1 2 3 4 | mysql> SELECT * FROM SELECT * FROM my_simple;ERROR 1064 (42000): You have an error in your SQL syntax; check the manual that corresponds to your MySQL server version for the right syntax to use near 'SELECT * FROM my_simple' at line 1mysql> SELECT * FROM (SELECT * FROM my_simple);ERROR 1248 (42000): Every derived table must have its own alias |
正确示例
1 2 3 4 5 6 7 8 9 10 | mysql> SELECT * FROM (SELECT * FROM my_simple) AS simple_my;+------+| name |+------+| a || b || c || d |+------+4 rows in set (0.00 sec) |
从这我们也知道了as不仅能给字段做别名,也能给表做别名
Where子句
Where字句:用来从数据表获取数据的时候进行条件筛选
数据获取原理:针对表去对应的磁盘处获取所有的记录(一条条),where的作用就是在拿到一条结果就开始进行判断,判断是否符合条件,如果符合就保存下来,如果不符合直接舍弃(不放到内存中)
Where是通过运算符进行结果比较来判断数据
Group by子句
Group by表示分组的含义:根据指定的字段,将数据进行分组,目的是为了统计
分组统计
基本语法:GROUP BY 字段名;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | mysql> SELECT * FROM my_student;+---------+----------+----------+---------+------------+| stu_id | stu_name | class_id | stu_age | stu_height |+---------+----------+----------+---------+------------+| stu0001 | 夏洛 | 1 | 18 | 185 || stu0002 | 张四 | 1 | 28 | 165 || stu0003 | 张五 | 2 | 22 | 187 || stu0004 | 小婷 | 2 | 25 | 189 |+---------+----------+----------+---------+------------+4 rows in set (0.00 sec) mysql> SELECT * FROM my_student GROUP BY class_id;+---------+----------+----------+| stu_id | stu_name | class_id |+---------+----------+----------+| stu0001 | 夏洛 | 1 || stu0003 | 张五 | 2 |+---------+----------+----------+2 rows in set (0.03 sec) |
group by是为了分组后进行数据统计的,group by将数据按照指定的字段分组之后,只会保留每组的第一条记录,如果只是想看数据显示,那么group by用处不大
那么怎么统计呢? 可以借助一些统计函数:
- count():计数,统计每组中的数量,如果统计目标是字段,那么不统计为空NULL字段,如果为“*”,那么代表统计记录
- avg():求平均值(average)
- sum():求和
- group_concat():组内字符串合并
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | mysql> SELECT * FROM my_student;+---------+----------+----------+---------+------------+| stu_id | stu_name | class_id | stu_age | stu_height |+---------+----------+----------+---------+------------+| stu0001 | 夏洛 | 1 | 18 | 185 || stu0002 | 张四 | 1 | 28 | 165 || stu0003 | 张五 | 2 | 22 | 187 || stu0004 | 小婷 | 2 | 25 | 189 |+---------+----------+----------+---------+------------+4 rows in set (0.00 sec)mysql> -- 使用聚合函数:按照班级统计每班人数,最大年龄,最矮的身高,平均年龄mysql> SELECT class_id,GROUP_CONCAT(stu_name),COUNT(*),MAX(stu_age),MIN(stu_height),AVG(stu_age) FROM my_student GROUP BY class_id;+----------+------------------------+----------+--------------+-----------------+--------------+| class_id | GROUP_CONCAT(stu_name) | COUNT(*) | MAX(stu_age) | MIN(stu_height) | AVG(stu_age) |+----------+------------------------+----------+--------------+-----------------+--------------+| 1 | 夏洛,张四 | 2 | 28 | 165 | 23.0000 || 2 | 张五,小婷 | 2 | 25 | 187 | 23.5000 |+----------+------------------------+----------+--------------+-----------------+--------------+2 rows in set (0.01 sec) |
多分组
将数据按照某个字段进行分组之后,对已经分组的数据按照另一个字段进行再次分组
基本语法:GROUP BY 字段1,字段2,...;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | mysql> SELECT * FROM my_student;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0001 | 夏洛 | 1 | 18 | 185 | 男 || stu0002 | 张四 | 1 | 28 | 165 | 女 || stu0003 | 张五 | 2 | 22 | 187 | 男 || stu0004 | 小婷 | 2 | 25 | 189 | 女 || stu0005 | 小猪 | 1 | 30 | 173 | 女 || stu0006 | 小狗 | 2 | 18 | 170 | 男 |+---------+----------+----------+---------+------------+--------+6 rows in set (0.00 sec)mysql> SELECT class_id,gender,COUNT(*),GROUP_CONCAT(stu_name) FROM my_student GROUP BY class_id,gender;+----------+--------+----------+------------------------+| class_id | gender | COUNT(*) | GROUP_CONCAT(stu_name) |+----------+--------+----------+------------------------+| 1 | 男 | 1 | 夏洛 || 1 | 女 | 2 | 张四,小猪 || 2 | 男 | 2 | 张五,小狗 || 2 | 女 | 1 | 小婷 |+----------+--------+----------+------------------------+4 rows in set (0.00 sec) |
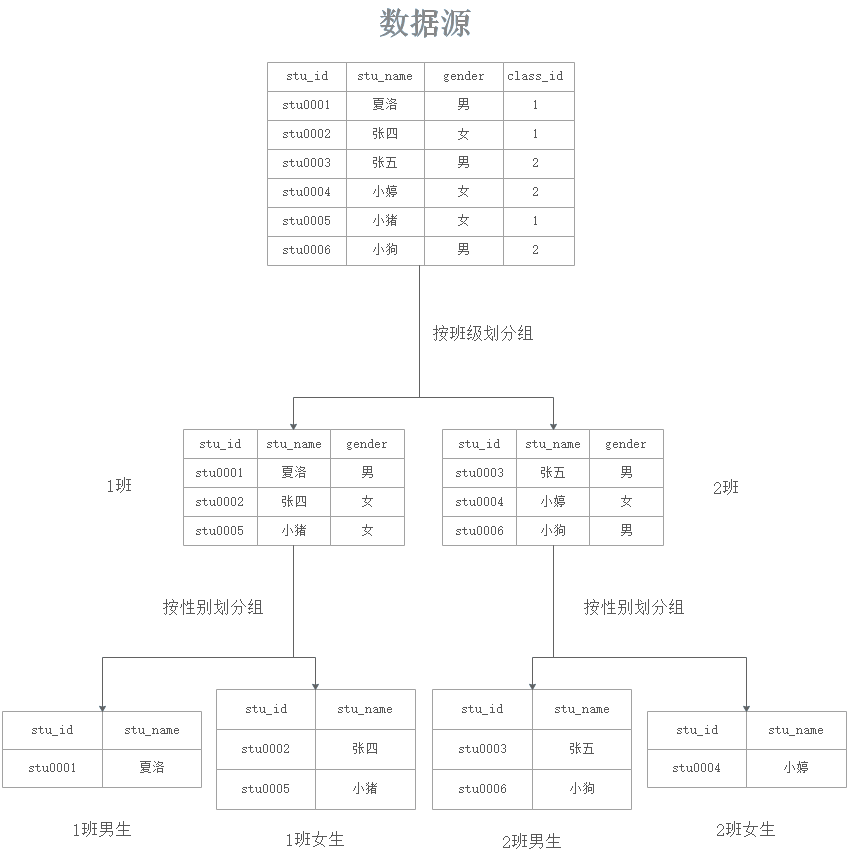
可以理解为将所有学生按班级分为“1班”和“2班”两组,这两组再按性别各分为“1班男生”、“1班女生”和“2班男生”、“2班女生”
过程如下
回溯统计
我感觉回溯统计像是多分组的及逆统计过程
数据进行多分组之后,向上统计的过程中,需要进行层层上报,将这种层层上报统计的过程称之为回溯统计:每一次分组向上统计的过程都会产生一次新的统计数据,而且当前数据对应的分组字段为NULL
基本语法:GROUP BY 字段 WITH ROLLUP;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | mysql> SELECT * FROM my_student;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0001 | 夏洛 | 1 | 18 | 185 | 男 || stu0002 | 张四 | 1 | 28 | 165 | 女 || stu0003 | 张五 | 2 | 22 | 187 | 男 || stu0004 | 小婷 | 2 | 25 | 189 | 女 || stu0005 | 小猪 | 1 | 30 | 173 | 女 || stu0006 | 小狗 | 2 | 18 | 170 | 男 |+---------+----------+----------+---------+------------+--------+6 rows in set (0.00 sec)mysql> SELECT class_id,gender,COUNT(*),GROUP_CONCAT(stu_name) FROM my_student GROUP BY class_id,gender WITH ROLLUP;+----------+--------+----------+-------------------------------------------+| class_id | gender | COUNT(*) | GROUP_CONCAT(stu_name) |+----------+--------+----------+-------------------------------------------+| 1 | 男 | 1 | 夏洛 || 1 | 女 | 2 | 张四,小猪 || 1 | NULL | 3 | 夏洛,张四,小猪 || 2 | 男 | 2 | 张五,小狗 || 2 | 女 | 1 | 小婷 || 2 | NULL | 3 | 张五,小狗,小婷 || NULL | NULL | 6 | 夏洛,张四,小猪,张五,小狗,小婷 |+----------+--------+----------+-------------------------------------------+7 rows in set (0.00 sec) |
多分组的过程是:数据源 -> 按班级分组 -> 按性别分组 -> 最终结果
而回溯统计的过程是:最终结果 -> 不同性别合并 -> 不同班级合并 -> 数据源
每一处合并都统计,按什么字段合并什么字段就变为NULL
Having子句
having的本质和where一样,是用来进行数据条件筛选
having的语法也与where类似
having是在group by子句之后,可以针对分组数据进行统计筛选,where不可以
比如说我要查询班级人数大于等于4的班级
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | mysql> SELECT * FROM my_student;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0001 | 夏洛 | 1 | 18 | 185 | 男 || stu0002 | 张四 | 1 | 28 | 165 | 女 || stu0003 | 张五 | 2 | 22 | 187 | 男 || stu0004 | 小婷 | 2 | 25 | 189 | 女 || stu0005 | 小猪 | 1 | 30 | 173 | 女 || stu0006 | 小狗 | 2 | 18 | 170 | 男 || stu0007 | 小江 | 1 | 25 | 178 | 女 |+---------+----------+----------+---------+------------+--------+7 rows in set (0.02 sec)mysql> SELECT class_id,count(*) AS number FROM my_student WHERE count(*)>=4 GROUP BY class_id;ERROR 1111 (HY000): Invalid use of group function |
报错是因为where不能使用聚合函数,聚合函数是用在group by分组之后,此时where已经运行完毕
having在group by分组之后发挥作用,因此可以使用聚合函数或者字段别名(where是从磁盘的表中取出数据,别名是在数据进入到内存之后才有的)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | mysql> SELECT * FROM my_student;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0001 | 夏洛 | 1 | 18 | 185 | 男 || stu0002 | 张四 | 1 | 28 | 165 | 女 || stu0003 | 张五 | 2 | 22 | 187 | 男 || stu0004 | 小婷 | 2 | 25 | 189 | 女 || stu0005 | 小猪 | 1 | 30 | 173 | 女 || stu0006 | 小狗 | 2 | 18 | 170 | 男 || stu0007 | 小江 | 1 | 25 | 178 | 女 |+---------+----------+----------+---------+------------+--------+7 rows in set (0.00 sec)mysql> SELECT class_id,count(*) AS number FROM my_student GROUP BY class_id HAVING number>=4;+----------+--------+| class_id | number |+----------+--------+| 1 | 4 |+----------+--------+1 row in set (0.00 sec) |
强调:having是在group by之后,where是在group by之前,使用where的时候表示将数据从磁盘拿到内存,where之后的所有操作都是内存操作
Order by子句
Order by排序:根据校对规则对数据进行排序
基本语法:ORDER BY 字段 [ASC|DESC];
asc(默认选项):升序(Ascending)
desc:降序(Descending)
示例
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | mysql> -- 班级学生按照身高排序mysql> SELECT * FROM my_student ORDER BY stu_height ASC;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0002 | 张四 | 1 | 28 | 165 | 女 || stu0006 | 小狗 | 2 | 18 | 170 | 男 || stu0005 | 小猪 | 1 | 30 | 173 | 女 || stu0007 | 小江 | 1 | 25 | 178 | 女 || stu0001 | 夏洛 | 1 | 18 | 185 | 男 || stu0003 | 张五 | 2 | 22 | 187 | 男 || stu0004 | 小婷 | 2 | 25 | 189 | 女 |+---------+----------+----------+---------+------------+--------+7 rows in set (0.01 sec) |
Order by可以进行多字段排序:先按照第一个字段进行排序,然后再按照第二个字段进行排序...
基本语法:ORDER BY 字段1 [ASC|DESC],字段2 [ASC|DESC];
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | mysql> -- 按照班级以及身高排序mysql> SELECT * FROM my_student ORDER BY class_id DESC,stu_height;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0006 | 小狗 | 2 | 18 | 170 | 男 || stu0003 | 张五 | 2 | 22 | 187 | 男 || stu0004 | 小婷 | 2 | 25 | 189 | 女 || stu0002 | 张四 | 1 | 28 | 165 | 女 || stu0005 | 小猪 | 1 | 30 | 173 | 女 || stu0007 | 小江 | 1 | 25 | 178 | 女 || stu0001 | 夏洛 | 1 | 18 | 185 | 男 |+---------+----------+----------+---------+------------+--------+7 rows in set (0.00 sec) |
Limit子句
Limit限制子句:主要是用来限制记录数量获取
记录数限制
纯粹的限制获取的数量,从第一条到指定的数量
基本语法:limit 数量;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | mysql> SELECT * FROM my_student;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0001 | 夏洛 | 1 | 18 | 185 | 男 || stu0002 | 张四 | 1 | 28 | 165 | 女 || stu0003 | 张五 | 2 | 22 | 187 | 男 || stu0004 | 小婷 | 2 | 25 | 189 | 女 || stu0005 | 小猪 | 1 | 30 | 173 | 女 || stu0006 | 小狗 | 2 | 18 | 170 | 男 || stu0007 | 小江 | 1 | 25 | 178 | 女 |+---------+----------+----------+---------+------------+--------+7 rows in set (0.00 sec)mysql> SELECT * FROM my_student LIMIT 2;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0001 | 夏洛 | 1 | 18 | 185 | 男 || stu0002 | 张四 | 1 | 28 | 165 | 女 |+---------+----------+----------+---------+------------+--------+2 rows in set (0.00 sec) |
分页
利用limit来限制获取指定区间的数据
基本语法:LIMIT offset,length;
offset:偏移量,也就是说从哪开始
length:就是具体要获取多少条记录
注意:Mysql中记录的数量是从0开始的,例如LIMIT 0,2;表示获取前两条记录
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | mysql> SELECT * FROM my_student;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0001 | 夏洛 | 1 | 18 | 185 | 男 || stu0002 | 张四 | 1 | 28 | 165 | 女 || stu0003 | 张五 | 2 | 22 | 187 | 男 || stu0004 | 小婷 | 2 | 25 | 189 | 女 || stu0005 | 小猪 | 1 | 30 | 173 | 女 || stu0006 | 小狗 | 2 | 18 | 170 | 男 || stu0007 | 小江 | 1 | 25 | 178 | 女 |+---------+----------+----------+---------+------------+--------+7 rows in set (0.05 sec)mysql> SELECT * FROM my_student LIMIT 0,2;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0001 | 夏洛 | 1 | 18 | 185 | 男 || stu0002 | 张四 | 1 | 28 | 165 | 女 |+---------+----------+----------+---------+------------+--------+2 rows in set (0.00 sec)mysql> SELECT * FROM my_student LIMIT 2,2;+---------+----------+----------+---------+------------+--------+| stu_id | stu_name | class_id | stu_age | stu_height | gender |+---------+----------+----------+---------+------------+--------+| stu0003 | 张五 | 2 | 22 | 187 | 男 || stu0004 | 小婷 | 2 | 25 | 189 | 女 |+---------+----------+----------+---------+------------+--------+2 rows in set (0.00 sec) |
注意:limit后面的length表示最多获取的数量,但是如果数量不够,系统并不会强求